Architektur eines neuronalen Netzes · CNN Generator
Kostenloser Online-Generator für Architektur eines neuronalen Netzes · CNN: in rund 90 Sekunden eine vollständig beschriftete Abbildung. Die KI plant zuerst die Pflicht-Beschriftungen und zeichnet dann ein Diagramm im Lehrbuchstil — jede Beschriftung bleibt editierbar, fertig für Paper, Hausaufgaben und Folien.
Beschriftungen in diesem Diagramm
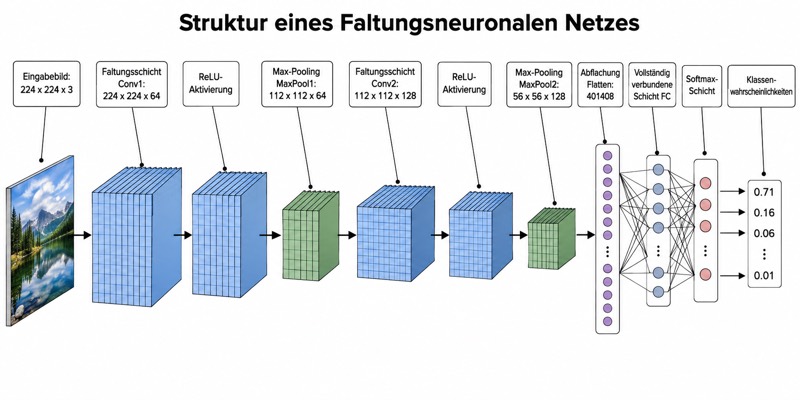
- Eingabebild: 224 x 224 x 3
- Faltungsschicht Conv1: 224 x 224 x 64
- ReLU-Aktivierung
- Max-Pooling MaxPool1: 112 x 112 x 64
- Faltungsschicht Conv2: 112 x 112 x 128
- ReLU-Aktivierung
- Max-Pooling MaxPool2: 56 x 56 x 128
- Merkmalskarten
- Abflachung Flatten: 401408
- Vollständig verbundene Schicht FC
- Softmax-Schicht
- Klassenwahrscheinlichkeiten
✓ Exakte Beschriftungen ✓ Text nachträglich editierbar ✓ PNG für Paper, Poster & Folien
 OUTPUT · 16:9 · PNG
Was diese Abbildung zeigt
Die Abbildung zeigt die Architektur eines Convolutional Neural Network zur Bildklassifikation. Ausgangspunkt ist ein Eingabebild mit 224 × 224 Pixeln und drei Farbkanälen. Conv1 erzeugt daraus 64 Merkmalskarten der Größe 224 × 224; die räumliche Auflösung bleibt durch geeignetes Padding erhalten. Eine ReLU-Aktivierung führt Nichtlinearität ein. MaxPool1 reduziert anschließend Breite und Höhe auf 112 × 112. Conv2 extrahiert 128 komplexere Merkmalskarten, bevor MaxPool2 die Auflösung auf 56 × 56 verkleinert. Die dreidimensionalen Quader stellen jeweils Breite, Höhe und Kanaltiefe der Aktivierungstensoren dar.
Die Pfeile kennzeichnen die Vorwärtspropagation von niedrigstufigen Bildmerkmalen zu Klassenwahrscheinlichkeiten. Faltungsschichten lernen lokale Filter für Kanten, Texturen und zunehmend komplexe Muster; ReLU setzt negative Aktivierungen auf null. Das Max-Pooling fasst lokale Bereiche zusammen, senkt den Rechenaufwand und erhöht die Robustheit gegenüber kleinen Verschiebungen. Nach MaxPool2 besitzt der Tensor 56 × 56 × 128 = 401408 Werte. Flatten ordnet diese Aktivierungen zu einem eindimensionalen Vektor, ohne neue Merkmale zu berechnen. Die vollständig verbundene Schicht kombiniert die extrahierten Informationen global. Abschließend normiert Softmax die Ausgabewerte zu einer Wahrscheinlichkeitsverteilung über die vorgegebenen Klassen.
Was eine korrekte Abbildung enthalten muss
- Eingabebild mit 224 × 224 × 3: Breite, Höhe und drei Farbkanäle müssen eindeutig angegeben und als dreidimensionaler Tensor dargestellt werden.
- Conv1 mit 224 × 224 × 64: Die 64 Ausgabekanäle entsprechen der Anzahl gelernter Filter; gleichbleibende Bildmaße setzen typischerweise Schrittweite 1 und geeignetes Padding voraus.
- ReLU nach jeder Faltung: Die Aktivierungsfunktion ist als eigener Verarbeitungsschritt einzuzeichnen, weil sie Nichtlinearität erzeugt und negative Werte auf null setzt.
- MaxPool1 mit 112 × 112 × 64: Bei einem 2 × 2-Pooling mit Schrittweite 2 halbieren sich Breite und Höhe, während die Kanaltiefe unverändert bleibt.
- Conv2 und MaxPool2: Conv2 erhöht die Kanaltiefe auf 128, MaxPool2 reduziert die räumliche Größe anschließend korrekt auf 56 × 56 × 128.
- Merkmalskarten als Quader: Mit zunehmender Netztiefe sollten die Quader räumlich kleiner, aber tiefer dargestellt werden, um Dimensionsänderungen sichtbar zu machen.
- Flatten mit 401408 Elementen: Der Wert muss rechnerisch aus 56 × 56 × 128 hervorgehen; Flatten verändert nur die Anordnung, nicht die Anzahl der Werte.
- FC- und Softmax-Ausgabe: Die vollständig verbundene Schicht führt zur Anzahl der Klassen, Softmax liefert daraus normierte Klassenwahrscheinlichkeiten; Pfeile zeigen den durchgängigen Datenfluss von links nach rechts.
Häufige Fehler
- Die Kanaltiefe wird beim Max-Pooling fälschlich halbiert. Übliches räumliches Max-Pooling reduziert nur Breite und Höhe, nicht die Zahl der Merkmalskarten.
- ReLU wird vor der Faltung oder erst nach dem Pooling eingezeichnet. In der dargestellten Blockfolge gilt jeweils Conv → ReLU → MaxPool.
- Flatten wird als lernende Schicht interpretiert. Tatsächlich formt es den Tensor 56 × 56 × 128 lediglich in einen Vektor mit 401408 Einträgen um.
- Die Größe 224 × 224 bleibt nach Conv1 ohne Erklärung erhalten. Dies ist nur bei passender Wahl von Filtergröße, Padding und Schrittweite konsistent.
- Softmax wird mit der Klassenzuordnung verwechselt. Softmax erzeugt Wahrscheinlichkeiten; die vorhergesagte Klasse ergibt sich meist erst durch die Auswahl des größten Werts.
Tipps für den Unterricht
Die Grafik eignet sich nach der Einführung von Faltung, Aktivierungsfunktion und Pooling zur Sicherung des gesamten Vorwärtswegs. Studierende können an jeder Schicht die Tensorform bestimmen und begründen, warum die räumliche Auflösung sinkt, während die Kanaltiefe steigt. Leitfragen sind: Welche Parameter werden gelernt? Warum bleibt die Tiefe beim Pooling konstant? Wie entsteht der Flatten-Wert 401408? Als Prüfungsaufgabe lassen sich fehlende Dimensionen, die Reihenfolge Conv–ReLU–Pool sowie die Rollen von Flatten, vollständig verbundener Schicht und Softmax abfragen. Zusätzlich kann die Zahl der Aktivierungen als Grundlage für Speicher- und Rechenaufwandsabschätzungen dienen.
Fragen zu dieser Abbildung
Warum bleibt die räumliche Größe nach Conv1 und Conv2 unverändert?
Bei Schrittweite 1 kann ein geeignetes Padding die durch den Faltungskern verursachte Verkleinerung ausgleichen. Für einen ungeraden Kern der Größe k wird häufig auf jeder Seite ein Padding von (k − 1) / 2 verwendet.
Warum nimmt die Zahl der Merkmalskarten von 64 auf 128 zu?
Jeder Filter erzeugt eine eigene Merkmalskarte. Tiefere Schichten verwenden oft mehr Filter, damit sie vielfältigere und komplexere Muster erfassen können, während Pooling gleichzeitig die räumliche Auflösung reduziert.
Was ist der Unterschied zwischen der vollständig verbundenen Schicht und Softmax?
Die vollständig verbundene Schicht berechnet aus dem Merkmalsvektor Klassenwerte, die als Logits bezeichnet werden. Softmax transformiert diese Logits in nichtnegative Werte mit einer Summe von 1 und macht sie dadurch als Klassenwahrscheinlichkeiten interpretierbar.