Générateur de Architecture d’un réseau de neurones · CNN
Générateur en ligne gratuit de Architecture d’un réseau de neurones · CNN : une figure entièrement légendée en environ 90 secondes. L'IA planifie d'abord les légendes indispensables, puis dessine un schéma de style manuel scolaire — chaque légende reste modifiable, prêt pour articles, devoirs et diapos.
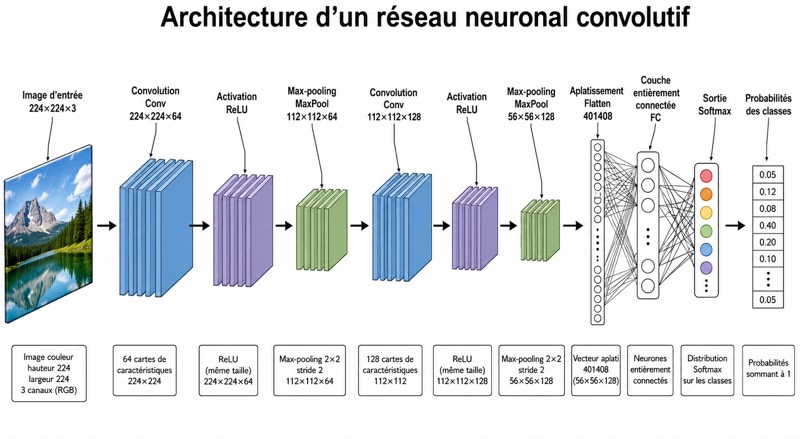
Légendes incluses dans ce schéma
- Image d’entrée 224×224×3
- Convolution Conv 224×224×64
- Activation ReLU
- Max-pooling MaxPool 112×112×64
- Convolution Conv 112×112×128
- Activation ReLU
- Max-pooling MaxPool 56×56×128
- Aplatissement Flatten 401408
- Couche entièrement connectée FC
- Sortie Softmax
- Probabilités des classes
✓ Légendes exactes ✓ Texte modifiable ✓ PNG pour articles, posters et diapos
 OUTPUT · 16:9 · PNG
Ce que montre ce schéma
Ce schéma décrit l’architecture séquentielle d’un réseau de neurones convolutif destiné à la classification d’images. Une image d’entrée de 224 × 224 pixels et de trois canaux traverse une première convolution produisant 64 cartes de caractéristiques, puis une activation ReLU et un sous-échantillonnage par maximum. Une seconde convolution porte la profondeur à 128 cartes, suivie des mêmes opérations. Le tenseur final de dimensions 56 × 56 × 128 est aplati en un vecteur de 401 408 valeurs, traité par une couche entièrement connectée. La couche Softmax transforme enfin les scores obtenus en probabilités associées aux classes.
Les flèches indiquent la propagation avant et imposent un ordre de calcul précis. Les convolutions apprennent des filtres locaux capables de détecter progressivement contours, textures et motifs plus complexes. ReLU introduit une non-linéarité en remplaçant les valeurs négatives par zéro. Chaque MaxPool réduit ici de moitié la hauteur et la largeur, sans modifier le nombre de canaux : 224 × 224 × 64 devient 112 × 112 × 64, puis 112 × 112 × 128 devient 56 × 56 × 128. L’aplatissement conserve le nombre total d’activations, car 56 × 56 × 128 = 401 408, mais supprime leur organisation spatiale avant la classification.
Ce qu'un schéma correct doit contenir
- Image d’entrée 224 × 224 × 3 : représenter un tenseur tridimensionnel dont les deux premières dimensions sont spatiales et dont la profondeur correspond aux trois canaux de couleur.
- Première convolution 224 × 224 × 64 : montrer 64 cartes de caractéristiques et préciser que la conservation de la résolution suppose un remplissage adapté, généralement un remplissage dit « identique ».
- Activation ReLU : la placer immédiatement après chaque convolution pour introduire une non-linéarité sans changer les dimensions du tenseur.
- Premier MaxPool 112 × 112 × 64 : illustrer la division par deux de la hauteur et de la largeur, typiquement avec une fenêtre 2 × 2 et un pas de 2.
- Deuxième bloc convolutif : faire apparaître successivement la convolution 112 × 112 × 128, ReLU, puis MaxPool 56 × 56 × 128 afin de montrer l’augmentation du nombre de canaux et la réduction spatiale.
- Aplatissement de taille 401 408 : vérifier explicitement le calcul 56 × 56 × 128 et représenter le passage du tenseur tridimensionnel à un vecteur.
- Couche entièrement connectée et sortie Softmax : relier le vecteur aux scores de classes, puis aux probabilités, dont la somme doit être égale à 1.
- Flèches de propagation avant : les orienter de gauche à droite entre toutes les étapes, sans saut ambigu, et conserver une représentation cohérente des cartes par des pavés tridimensionnels.
Erreurs fréquentes
- Confondre profondeur et résolution : les 64 ou 128 valeurs désignent le nombre de cartes de caractéristiques, et non la largeur ou la hauteur de l’image.
- Attribuer à ReLU une réduction de dimensions : cette activation modifie les valeurs, mais conserve la forme complète du tenseur.
- Réduire aussi le nombre de canaux lors du MaxPool : dans cette architecture, le sous-échantillonnage agit uniquement sur les dimensions spatiales.
- Calculer incorrectement l’aplatissement : le vecteur contient 56 × 56 × 128 = 401 408 composantes, et non 56 × 56 ou 128 seulement.
- Présenter Softmax comme une couche d’extraction de caractéristiques : elle intervient à la fin pour normaliser les scores en probabilités de classes.
Conseils pédagogiques
Cette figure convient à l’introduction de la propagation avant, puis à une séance d’analyse dimensionnelle des tenseurs. L’enseignant peut masquer certaines tailles et demander aux étudiants de retrouver 112 × 112 × 64, 56 × 56 × 128 et 401 408. Des questions ciblées permettent d’expliquer pourquoi la profondeur augmente alors que la résolution diminue, ou pourquoi ReLU ne change pas les dimensions. Le schéma prépare directement aux exercices portant sur le remplissage, le pas, le nombre de paramètres, le champ réceptif, l’aplatissement et l’interprétation probabiliste de Softmax.
Questions sur ce schéma
Pourquoi les convolutions augmentent-elles le nombre de cartes de caractéristiques ?
Chaque filtre appris produit une carte sensible à un type de motif. Employer 64 puis 128 filtres permet de représenter une diversité croissante de caractéristiques, depuis les structures locales simples jusqu’aux combinaisons plus abstraites.
Pourquoi le MaxPool réduit-il la résolution sans réduire la profondeur ?
Le maximum est calculé séparément dans chaque carte de caractéristiques, généralement sur des fenêtres 2 × 2. Il diminue donc la hauteur et la largeur, tandis que le nombre de cartes reste inchangé.
Quelle différence existe-t-il entre l’aplatissement, la couche entièrement connectée et Softmax ?
L’aplatissement réorganise le tenseur en vecteur sans apprentissage. La couche entièrement connectée combine les composantes au moyen de poids appris, tandis que Softmax normalise les scores finaux pour obtenir une distribution de probabilités sur les classes.