Generador de Arquitectura de una red neuronal · CNN
Generador online gratuito de Arquitectura de una red neuronal · CNN: obtén una figura completamente etiquetada en unos 90 segundos. La IA planifica primero las etiquetas imprescindibles y luego dibuja un diagrama de estilo libro de texto; cada etiqueta es editable después, listo para artículos, tareas y diapositivas.
Etiquetas incluidas en este diagrama
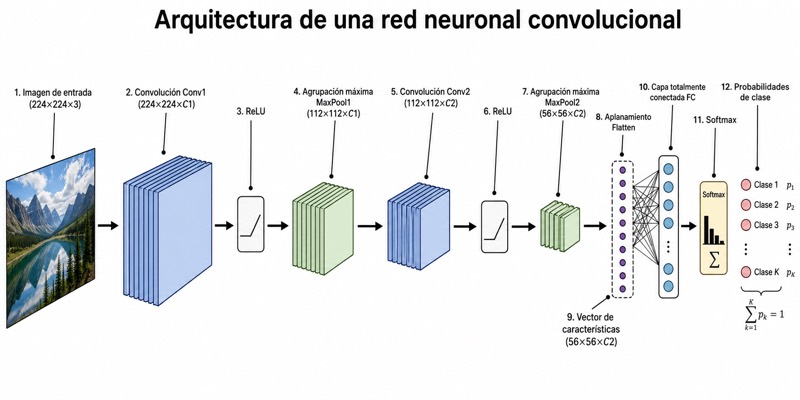
- Imagen de entrada (224×224×3)
- Convolución Conv1 (224×224×C1)
- ReLU
- Agrupación máxima MaxPool1 (112×112×C1)
- Convolución Conv2 (112×112×C2)
- ReLU
- Agrupación máxima MaxPool2 (56×56×C2)
- Aplanamiento Flatten
- Vector de características (56×56×C2)
- Capa totalmente conectada FC
- Softmax
- Probabilidades de clase
✓ Etiquetas precisas ✓ Texto editable ✓ PNG para artículos, pósteres y diapositivas
 OUTPUT · 16:9 · PNG
Qué muestra este diagrama
La figura representa la arquitectura básica de una red neuronal convolucional para clasificación de imágenes. Una imagen de entrada de 224×224×3 atraviesa dos bloques de extracción de características formados por convolución, activación ReLU y agrupación máxima. Conv1 genera C1 mapas de características conservando la resolución espacial de 224×224, mientras que Conv2 produce C2 mapas de 112×112. Las capas MaxPool reducen progresivamente la resolución hasta 56×56, conservando las respuestas más destacadas. Finalmente, las características se aplanan, pasan por una capa totalmente conectada y se transforman mediante Softmax en probabilidades asociadas a las clases posibles.
Las flechas indican la propagación hacia delante y deben mostrar un flujo continuo de izquierda a derecha. La convolución aplica filtros aprendibles para detectar patrones locales; ReLU introduce no linealidad mediante max(0, x), y MaxPool resume regiones vecinas reduciendo el coste computacional y aportando cierta invariancia a traslaciones pequeñas. Tras MaxPool2 se obtiene un tensor de 56×56×C2, donde C2 es el número de canales. Flatten reorganiza ese tensor como un vector de longitud 56·56·C2, sin aprender parámetros. La capa FC combina globalmente las características, genera puntuaciones o logits y Softmax las normaliza para que sean no negativas y sumen uno.
Qué debe incluir un diagrama correcto
- Imagen de entrada 224×224×3: debe dibujarse como un volumen con altura, anchura y tres canales de color claramente identificados.
- Convolución Conv1, 224×224×C1: represéntela como un conjunto de mapas de características y aclare que C1 depende del número de filtros aplicados.
- Activación ReLU después de cada convolución: colóquela en el orden correcto para indicar la introducción de no linealidad sin modificar normalmente las dimensiones.
- MaxPool1, 112×112×C1, y MaxPool2, 56×56×C2: muestre que reducen las dimensiones espaciales, pero conservan el número de canales.
- Segundo bloque Conv2–ReLU–MaxPool2: debe reflejar la extracción jerárquica de características más complejas y el cambio de C1 a C2 canales.
- Flatten y vector de características: diferencie el tensor 56×56×C2 del vector resultante, cuya longitud correcta es 56·56·C2.
- Capa totalmente conectada, Softmax y probabilidades de clase: dibuje los logits antes de Softmax y una salida con tantas componentes como clases.
- Flechas de propagación hacia delante: conéctelas sin saltos y mantenga coherentes las dimensiones entre la salida de una operación y la entrada de la siguiente.
Errores frecuentes
- Confundir los canales con las dimensiones espaciales: la convolución puede cambiar C1 por C2, mientras que el MaxPool habitual reduce altura y anchura, no canales.
- Escribir que Flatten produce un vector de dimensión 56×56×C2: esa es la forma del tensor previo; el vector tiene longitud 56·56·C2.
- Situar Softmax antes de la capa totalmente conectada o entre los bloques convolucionales, rompiendo la secuencia lógica de clasificación.
- Dibujar ReLU como una capa que reduce a la mitad el tamaño de los mapas, cuando normalmente conserva exactamente su forma.
- Afirmar que las probabilidades provienen directamente de MaxPool2: antes deben realizarse el aplanamiento, la combinación mediante FC y la normalización con Softmax.
Consejos didácticos
La figura resulta adecuada para introducir la propagación hacia delante después de estudiar convoluciones y antes de abordar el entrenamiento por retropropagación. El docente puede pedir al alumnado que calcule la forma de cada tensor, explique qué operación aprende parámetros y distinga extracción de características de clasificación. También puede ocultar algunas dimensiones y plantear preguntas como: «¿Qué longitud tendrá el vector tras Flatten?» o «¿Por qué MaxPool no cambia C1?». Los principales puntos evaluables son la secuencia Conv–ReLU–MaxPool, la interpretación de canales, el cálculo dimensional, la función de FC y la normalización probabilística de Softmax.
Preguntas sobre este diagrama
¿Por qué la convolución mantiene 224×224 y cambia el número de canales a C1?
La resolución se conserva si se emplean un paso de 1 y un relleno adecuado. Cada filtro produce un mapa de características, por lo que C1 coincide con el número de filtros de Conv1.
¿Qué diferencia existe entre ReLU y MaxPool?
ReLU transforma cada activación de forma independiente mediante max(0, x) y aporta no linealidad. MaxPool opera sobre ventanas espaciales, selecciona el valor máximo y reduce la altura y la anchura de los mapas.
¿Softmax clasifica por sí sola la imagen?
Softmax no extrae características ni aprende la decisión; normaliza los logits generados por la capa totalmente conectada. La clase predicha suele corresponder a la componente con mayor probabilidad, aunque durante el entrenamiento se emplea normalmente una función de pérdida como la entropía cruzada.